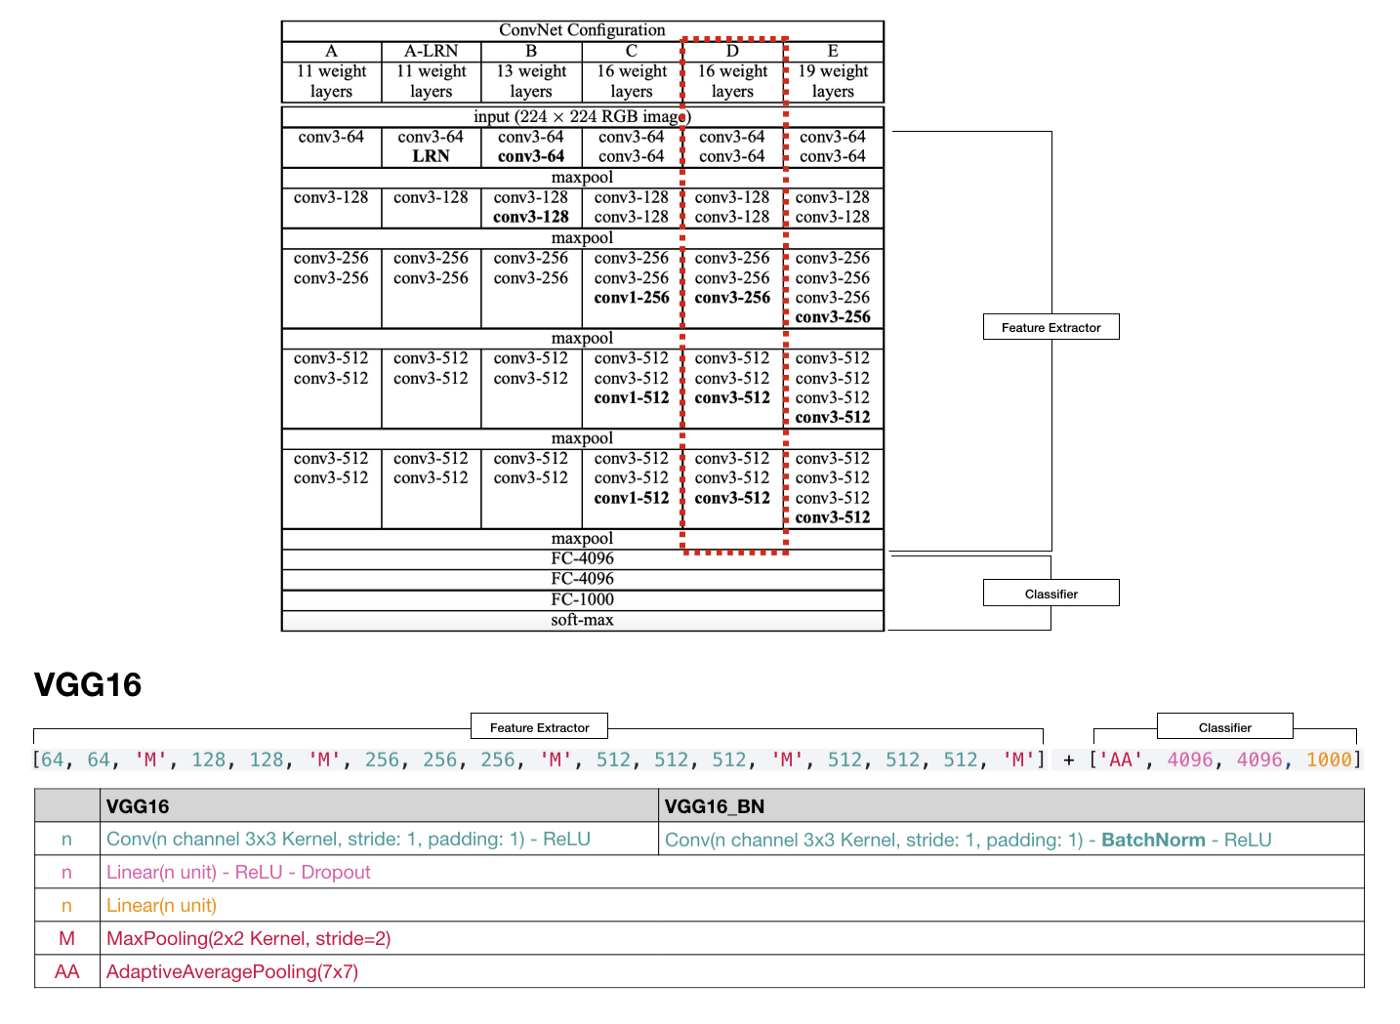
VGG-16 모델은 2014년 Very Deep Convolutional Networks for Large-Scale Image Recognition 논문으로 소개되어,
ImageNet Challenge에서 Top-5 테스트 정확도를 92.7% 달성면서 딥러닝을 활용한 CV 분야에서 큰 성과를 보인 architecture이다.
오늘은 이렇게 현재 가장 널리 쓰이고 있는 vision모델의 하나인 VGGNet에 대에서 탐구해보자.
우선 VGG의 뒤에 VGG-16, VGG-19와 같이 숫자가 붙어있는데, 이 부분은 layer의 깊이를 의미하는것이다.
VGG는 기존 AlexNet에서 적용하지 못했던 deep layer를 적용하여 성능을 크게 개선했다는데 큰 의미가 있다.
기존 AlexNet 오차율 | 16.4% –> VGGNet 오차율 7.6%
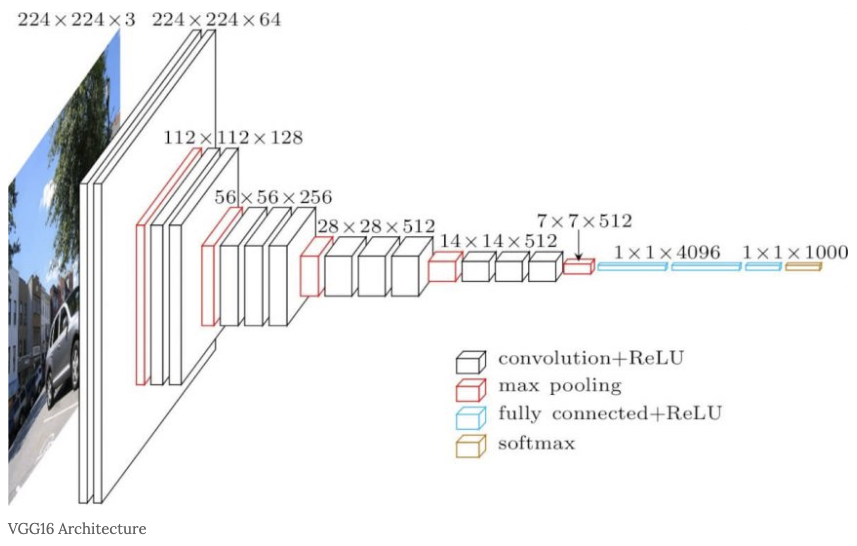
VGG-16 Architecture
VGG중에서 VGG-16을 기준으로, Architecture를 살펴보면,
- 흰색박스로 표현된 총 13개의 conv layer가 3개의 Fully-connected layer와 연결된 형태
- filter는 3x3으로 적용
- 붉은색박스로 표현된 2x2의 max-pooling이 적용