1. Background#
들어가기 전에 먼저 Few Shot Learning을 포함하는 개념인 Meta Learning이라는 개념을 먼저 짚고 넘어가고자 한다.
AI는 궁극적으로 AGI(Artificial General Intelligence, 일반 인공지능/범용 인공지능)로 나아갈 수 있어야하는데, Meta Learning은 AGI로 나아가는데 매우 중요한 디딤돌이 될 개념으로, 사람의 인식과정과 유사하게, “구분하는 방법"을 배우는 개념이다.
차이점을 구분하는 방법을 배운다
| 구분 | 학습방법 |
| 전통적 Deep Learning | 아르마딜로 사진 1000장 vs 천산갑 사진 1000장 반복 학습 |
| Meta Learning | 두 Class의 차이점을 구분하는 방법을 학습 |
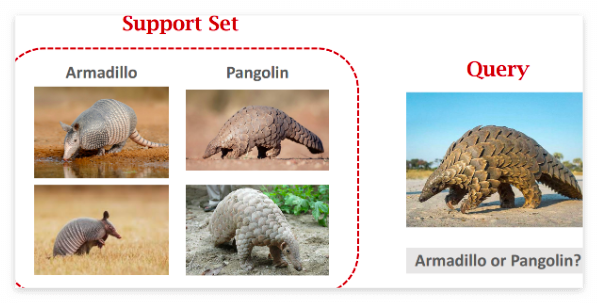
예를들어 천산갑과 아르마딜로를 전혀 보지 못한 어린아이가 위 사진(support set)만으로
Query 사진의 동물을 분류한다고 생각해보자.
→ 아마, 어린 아이는 아주 쉽게 query가 ‘천산갑’임을 알 수 있을 것이다.
HOW?#
사람은 데이터가 충분하지 않더라도 제시된 자료간의 차이점을 이해하는, 즉,**“구분하는 법”**을 배웠기 때문이다.
이렇게 사람의 인지과정과 유사하게 “구분하는 방법을 배우는 것"을 구현하는 학습 방법을 ‘Meta Learning’이라고 한다.
2. Few-Shot Learning ?#
Few Shot Learning은 이름처럼 아주 작은 데이터만으로 학습이 가능하다는 의미인가?
→ NO!#
Few Shot Learning은 Meta Learning의 방법론에 착안한 하나의 학습방법이며,
**“배우는 법”**을 배우기 위해서는 결국 “많은” 데이터가 필요하다.
다만, 기존의 학습방법과 다른점은 구분하려는 문제(아르마딜로냐 천산갑이냐)의 데이터는 Training set에 없어도 된다는 것이다.
→ pre-trained model을 활용한 medical image segmentation task에 적용해볼만하다.
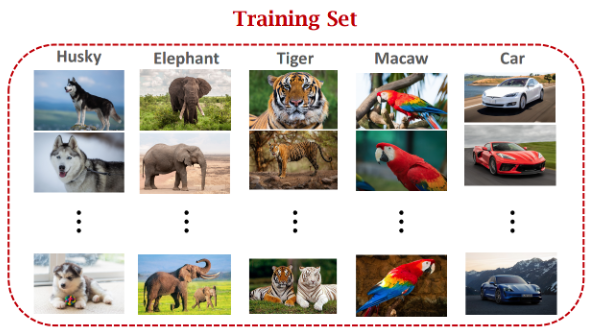
선행 학습이 필요한 Training Set
1. 기존 Supervised Learning :
Training set에 있는 Class에 해당하는 데이터를 예측
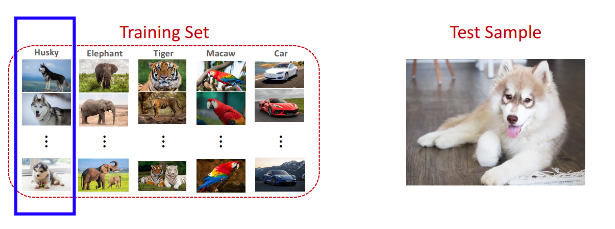
기존 Supervised Learning
2. Few Shot Learning :
Training set에 없는 Class를 맞추는 문제
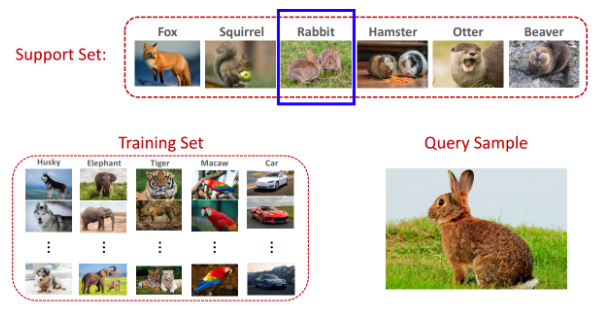
Few Shot Learning
Few Shot Learning을 위해서는 아래 세가지 Data set이 필요하다
| 데이터 종류 | Desc. |
| Training Set | prediction해야할 class와 관련없는 데이터들로 먼저 학습을 진행 → 차이점을 토대로 class를 분류하는 방법을 학습 |
| Support Set | 예측할 class와 관련된 1개(one-shot) 또는 n개(few-shot)의 support set을 학습 |
| Query image | 예측할 data를 Input |
Few Shot Learning은 “Support Set"의 형태에 따라 Accuracy가 달라진다.
Support set의 클래스 개수와 샘플 수(데이터 개수)에 따라k-way(k개의 클래스), n-shot(클래스별 데이터 개수)로 표현하는데,
클래스가 많아질수록, 클래스별 데이터가 적을수록 정확도는 낮아진다.
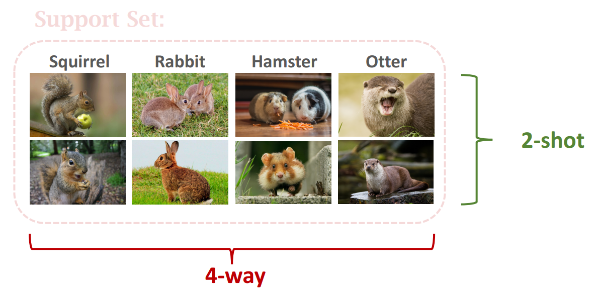
3. Few Shot Learning 학습 방법#
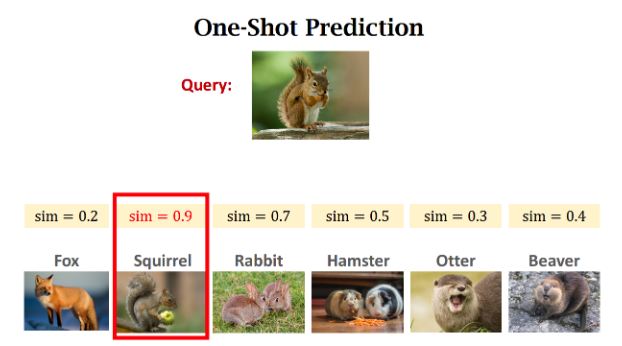
Few Shot Learning의 기본 학습방법은 **‘유사성’**을 학습하는 것이다
→ 즉, 두 개의 사진이 주어졌을때 각 사진을 잘 분석해서 두 사진이 “유사한지, 다른지"를 판단할 수 있다면
query image가 주어졌을때 Support set의 사진들과 비교하여 어떤 클래스에 속하는 지 알아낼 수 있다.
1) Step1 : Feature extraction of training set image
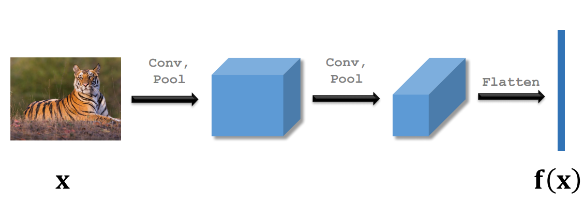
- 2) Step2 : Similarity calculation of Features hidden representation
Positive pair과 Negative pair에서 각각 한번씩 번갈아가며 학습을 진행
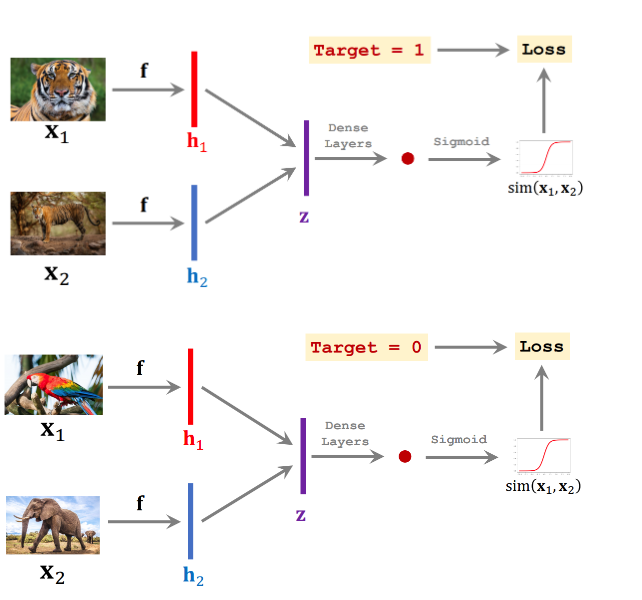
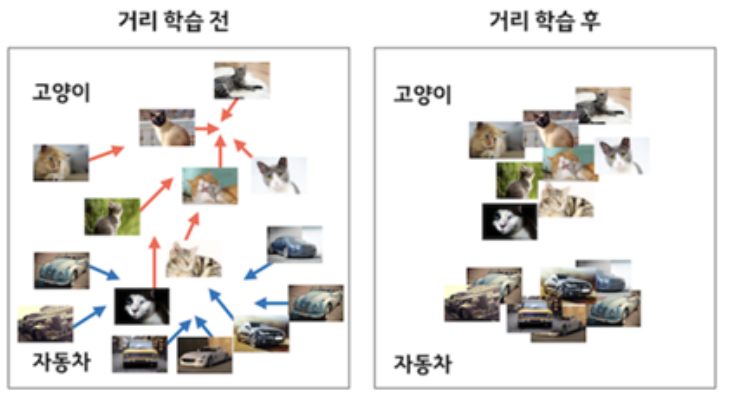
- 3) Step3 : support set을 기반으로 query image의 class 예측
step2에서 학습한 패턴을 기반으로 동일하게 support set과 query image의 유사도를 계산하여
Support의 class중 하나로 classification할 수 있다.