모 손해보험사의 보험 설계 에이전트를 개발하면서, 에이전트 내부에서 Tool 과 Sub-Agent 를 찾아오는 검색용 임베딩 모델을 보험 도메인에 맞춰 fine-tuning 했습니다. 결과 모델은 Hugging Face 에 wt-e5-small-ko-insurance-v1 으로 공개해 두었습니다.
(같은 시리즈의 다음 글에서는 긴 약관 문서를 VectorDB 에 적재하기 위한 인덱싱 전용 임베딩 모델을 다룹니다.)
1. 개발 배경#
1) 한국어 성능 측면#
과거 프로젝트 경험상, OpenAI 의 임베딩 모델(이전 버전인 text-embedding-3-large 등)은 다국어 학습 모델이지만 보험·금융처럼 한국어 특수 도메인에서는 한국어로 pre/fine-tuning 된 오픈소스 모델 대비 retrieval 정확도가 많이 떨어졌던 경험이 있었습니다.
이에, 한국어로 선학습된 모델에 보험 도메인 데이터로 fine-tuning 을 진행하면, 지금 개발 중인 에이전트의 Tool·Agent Retrieval 성능을 끌어올릴 수 있을 것으로 판단했습니다.
2) 프로덕션 운용 측면#
온프렘 후보로 검토한 dragonkue/multilingual-e5-small-ko-v2 의 경우, 118M params · 384 dim 의 작은 모델임에도 기본 한국어 embedding 및 retrieval 성능이 좋습니다.
물론, dimension 을 1,024 까지 올려서 후보군을 찾으면 BGE-M3, KURE-v1 같은 SoTA 모델이 있긴 합니다. 다만, 과거 프로덕션 환경에서 1,024 dimension 을 넘어가는 모델을 CPU 로 돌렸을 때 cpu 바운드로 인한 부하와 latency 이슈를 겪었던 적이 있어서, 에이전트단에서 CPU 로 구동할 모델은 768 dimension 미만으로 범위를 좁혀서 찾았습니다.
그리고 실제로 e5-small-ko-v2 를 에이전트에 붙여 보니, 기존 text-embedding-3-large 대비 response latency 가 30배 이상 빠르면서도 Retrieval 성능은 OpenAI 모델을 상회하는 것을 확인해서, 모델 교체의 근거로 삼을 수 있었습니다.
3) 규제 대응 → Region 이슈 사전 차단#
이 부분은 프로젝트를 같이 하던 동료가 짚어준 내용입니다.
데이터 국외 반출 제한 관점에서, OpenAI text-embedding-3-large 는 Korea Central + Standard SKU 로 배포할 수 있습니다. 다만 이 조건은 물리 데이터는 한국에 있지만 국외에서 access 가 가능한 구조라, 혁신금융서비스 심사 과정에서 문제가 될 소지가 있었습니다.
이에, 외부 API 의존을 줄이고 온프렘 모델로 전환하면 region / data residency 이슈를 근본적으로 차단할 수 있다고 봤습니다.
2. 학습 모델 선택 → e5-small-ko-v2#
한국어 embedding SoTA 인 KURE-v1 과 경량 모델 중 가장 성능이 좋은 e5-small-ko-v2 를 후보로 두고, OpenAI text-embedding-3-large 와 3자 비교를 진행했습니다. 비교는 고객사가 준 “질문별 호출 대상 Agent·Tool 매핑” 데이터로 만든 테스트셋 104건 기준입니다.
성능만 보면 KURE-v1 이 가장 좋았습니다. 그런데 아래처럼 e5-small-ko-v2 가 압도적으로 가볍고 빠르면서도 운영 가능한 수준의 Retrieval Accuracy 를 보여서, 최종 fine-tuning 대상으로 골랐습니다.
| model | Dimension | Disk | RAM (MB) | Latency |
|---|---|---|---|---|
| e5-small-ko-v2 (base) | 384 | 470MB | 213 | 7.4 ms |
| e5-small-ko-v2 + LoRA | 384 | + 2.6MB | + 5 | 13 ms |
| KURE-v1 | 1,024 | 2.3GB | 1,493 | 49.4 ms |
3. 목표#
“보험 도메인 특화 임베딩 모델 개발”
- 특정 고객사 데이터뿐 아니라 보험 도메인 전반의 embedding 성능 강화
- 실제 과제의 Agent·Tool Retrieval 성능 최적화
- e5-small-ko-v2 의 일반화 성능 유지 (overfitting 지양)
4. 학습 설계#
1) 학습 데이터 구축#
데이터는 크게 실 데이터, LLM 생성 데이터, 오픈소스 데이터 세 갈래로 구성했습니다.
| 구분 | 데이터 | 역할 | 건수 |
|---|---|---|---|
| 실 데이터 | 실제 Tool description | positive corpus | 15 |
| 실 데이터 | 실제 Sub-Agent description | positive corpus | 5 |
| LLM 생성 (gpt-5.4-mini) | 실 Tool 합성 query | 실 데이터 기반 유사 데이터 증강 | 15 × 80 = 1,200 |
| LLM 생성 | 실 Sub-Agent 합성 query | 실 데이터 기반 유사 데이터 증강 | 5 × 80 = 400 |
| LLM 생성 | 가상 보험 Tool desc + query | 보험 도메인 일반 증강 | 5 desc, 1,200 query |
| LLM 생성 | 가상 기타 Tool desc + query | 공공·금융 등 타 도메인 일반화 | 10 desc, 620 query |
| 오픈소스 | klue/mrc | 일반 한국어 retrieval | 3K ~ 10K |
| 오픈소스 | klue/sts (label ≥ 3.5) | 일반 의미 paraphrase | 2K ~ 7.5K |
(처음에는 약관 PDF 원문 42,626 페이지도 넣었는데, 오히려 Retrieval 성능이 떨어져서 뺐습니다. 이유는 7장 시행착오에 적어두었습니다.)
2) Loss Function → MNRL#
MultipleNegativesRankingLoss(MNRL)는 같은 batch 안의 다른 sample 들의 positive 를 negative pool 로 자동으로 쓰는, 임베딩 학습에서 대표적으로 쓰이는 contrastive loss 입니다. 정답 쌍은 가깝게, 나머지 쌍은 멀어지도록 학습합니다.
예를 들어 batch = 16 이면, anchor_i 기준으로 같은 배치 안의 나머지 15개 sample 의 positive_j 가 전부 anchor_i 의 negative 가 됩니다. 그래서 negative 쌍을 따로 만들 필요가 없습니다.
| Loss | 단점 |
|---|---|
| Triplet loss (단일 anchor-pos-neg) | negative 를 1개만 써서 학습 신호가 약함 |
| BCE / pointwise | ranking 학습이 어려움 |
| MNRL (채택) | batch 의 모든 sample 이 자동으로 negative → 학습 pool 이 넓어짐 |
3) Model Architecture → LoRA#
한국어 일반화 성능은 최대한 유지하면서 보험 도메인 성능만 올리기 위해, 기존 가중치 대부분은 freezing 하고 일부 레이어(adapter)만 학습하는 LoRA 방식을 썼습니다.
기존 base node 의 output 에 adapter node 의 output 을 “더하는” 구조라, vector space 안의 weight 와 bias 가 통째로 바뀌는 문제를 막아줍니다. 그래서 도메인 데이터에 대한 쪽집게 학습에 쓰기 좋습니다. 실제 최종 모델도 전체 117M 파라미터 중 405K(0.44%)만 학습했고, 나머지 99.6%는 freezing 된 채로 두었습니다. (학습 후 저장된 adapter 크기는 약 1.5MB)
LoRA 동작 방식은 예전에 정리해둔 LoRA 학습 방식 뜯어보기 글을 참고하면 됩니다.
| 항목 | 값 | 의미 |
|---|---|---|
| epochs | 4 | |
| r (rank) | 8 | adapter 행렬 차원. 클수록 capacity ↑, 망각도 ↑ |
| alpha | 16 | scaling factor (= 2r 관례). 실효 학습률 = lr × 2 |
| dropout | 0.05 | adapter 출력 5% drop (regularization) |
| target_modules | query, key, value, dense | 4종 module 에 LoRA 부착 |
| layers_to_transform | null (전체 12 layer) | 모든 layer 에 부착 |
| bias | None | bias 는 학습하지 않음 |
| task_type | FEATURE_EXTRACTION | classification head 없이 embedding 만 |
5. Train#
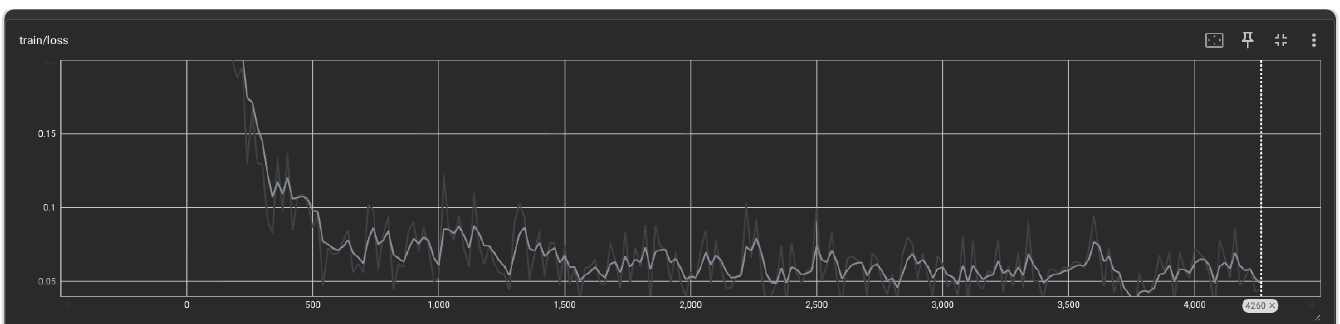
H100 80GB GPU 1장으로 학습했습니다.
학습 데이터는 MNRL 정규 포맷(query / positive / negatives)으로 만들었고, query 와 passage 앞에는 e5 계열 관례대로 prefix 를 붙였습니다.
{
  "query": "query: 해약하면 얼마 돌려받아?",
  "positive": "passage: 해약환급금조회 (getCancellationReturnAmount)\n[기능] 보험계약 해약 시 시점별 환급금을 조회한다.\n[동작 방식] 계약번호 + 해약 예정일 입력, 환급금/공시이율/사업비 차감 후 금액 계산.\n입력: ctrno (필수), expectDate (선택)\n출력: returnAmount, surrenderRatio, deductedFee",
  "negatives": [
    "passage: 보험금 청구 진행 조회 (getClaimProgress)\n[기능] 청구 접수된 건의 진행 단계와 담당자 정보를 조회한다 ...",
    "passage: 보험료 납입 내역 조회 (getPremiumPaymentHistory)\n[기능] 특정 계약의 최근 12개월 납입 내역을 조회한다 ...",
    "passage: 계약 상태 조회 (getPolicyStatus)\n[기능] 계약의 현재 상태(유효/실효/해지)와 다음 납입 예정일을 반환한다 ..."
  ]
}
6. Result#
1) 평가 기준#
| 기준 | 설명 |
|---|---|
| 도메인 평가셋 | 고객사 시트에서 발췌한 실제 query 104건 |
| NDCG@10 | top-10 안에서 정답이 위에 있을수록 높은 점수 |
| R@1 / R@3 | Tool 을 1개 / 3개 뽑았을 때 정답 포함 여부 |
| MRR@3 | 정답 순위 역수의 평균 (1위 1.0, 2위 0.5, 3위 0.33, 밖이면 0) |
| Holdout-1056 | gpt-5.4-mini 로 만든 대규모 holdout 1,056 query 의 종합 ranking 품질 |
| Extra holdout | 학습에 참여하지 않은 25개 sector 신규 tool(실손·카드·통신·세금 등) 750 query. 일반화 능력 측정 |
| General Tool Calling | 환율·영화·항공편 등 tool calling 테스트용 공개 데이터셋 (heegyu/glaive-function-calling-v2-ko) |
2) 평가 결과#
| 기준 | base e5-small-ko-v2 | LoRA (wt-e5-small-ko-insurance-v1) | OpenAI 3-large |
|---|---|---|---|
| 도메인 NDCG@10 | 0.630 | 0.773 (+14.3pt) | 0.634 |
| 도메인 R@1 | 0.385 | 0.596 (+21.1pt) | 0.337 |
| 도메인 R@3 | 0.562 | 0.716 (+15.4pt) | 0.635 |
| 도메인 MRR@3 | 0.492 | 0.670 (+17.8pt) | 0.463 |
| Holdout-1056 NDCG@10 | 0.8886 | 0.9053 (+1.7pt) | 0.8766 |
| Extra holdout NDCG@10 | 0.8616 | 0.9025 (+4.1pt) | 0.8985 |
| General Tool Calling NDCG@10 | 0.5175 | 0.5283 (+1.1pt) | 0.5193 |
| General Tool Calling R@10 | 0.7312 | 0.7502 (+2.0pt) | 0.7417 |
| Dimension | 384 | 384 | 3,072 |
| 추론 latency p50 | 7 ms | 13 ms | 네트워크 의존 |
| 의존성 | 로컬 | 로컬 | OpenAI API + private endpoint |
도메인 평가셋에서는 base 대비 NDCG@10 이 14.3pt 올랐고, OpenAI 3-large(0.634)보다도 높게 나왔습니다. 그리고 학습에 쓰지 않은 신규 tool(Extra holdout)과 공개 tool calling 데이터셋에서도 점수가 떨어지지 않고 소폭 올라서, 일반화 성능도 유지된 것으로 봤습니다.
7. 시행착오#
한 번에 된 건 아니고, 아래처럼 꽤 여러 번 돌았습니다.
| version | Issue | Try | Result |
|---|---|---|---|
| v1 | 도메인 align 학습 시도 | 고객사 홈페이지에서 모은 약관, 상품요약서로 학습 | 일반화·도메인 스코어 모두 대폭 하락 (-11.1pt) |
| v2 | 일반화 성능 저하 | 1트 : klue/mrc + klue/sts mix-in | 일반화 드리프트 약간 회복 (holdout +3.2pt) |
| 2트 : KL Distillation (base 출력을 정답 referent 로 써서 LoRA 가 너무 멀어지지 않게) | 일반화는 덜 튀었지만 여전히 소폭 하락, 도메인은 거의 그대로 | ||
| 3트 : target_modules 축소 (Q/K/V/dense → Q + V) | 일반화는 보존, 도메인 점수 하락 | ||
| 4트 : layers_to_transform 으로 상위 N 개 layer 만 부착 (top-4 / 6 / 8) | top-6 Q+V 가 holdout 최고치. 단 도메인 0.657 로 capacity 부족 | ||
| 5트 : 다시 Full(12 layer × Q+K+V+dense = 48 module) + epoch 2 → 4 | holdout, 도메인 모두 최고 성능 |
v1 의 경우, 약관과 상품요약서에 담긴 개념적인 워딩이 실제 Agent·Tool Retrieval 의 문장 패턴이나 맥락과는 성격이 맞지 않아서 오히려 성능이 떨어진 것으로 보입니다. 약관 데이터는 tool description 검색이 아니라 정보 검색 목적의 임베딩에서 효과가 있을 데이터라고 판단했고, 이 판단이 다음 글의 인덱싱 전용 모델로 이어졌습니다.
그리고 4트에서 일반화를 지키려고 학습 범위를 줄일수록 도메인 점수가 내려가는 걸 보고, trade-off 구간에 들어선 게 아닐까 의심했었습니다. 결과적으로는 범위를 줄이는 게 답이 아니었고, 도메인 데이터 대비 학습 강도가 부족했던 쪽이었습니다.
8. 마치며#
- OpenAI text-embedding-3-large 는 다국어 모델이긴 하나, 한국어 특수 도메인에서는 한국어로 pre/fine-tuning 된 모델의 base 성능이 이미 꽤 큰 차이로 앞섰습니다.
- 데이터가 많지 않아도(실 description 20건 + 증강) 경량 임베딩 모델의 도메인 성능을 충분히 끌어올릴 수 있었습니다.
- 프로젝트에서 온프렘 모델로 OpenAI 임베딩을 대체할 수 있다는 걸 확인했고, 다른 도메인에서도 자체 임베딩 모델을 운용할 수 있는 레퍼런스를 하나 확보했습니다.
- Hugging Face : https://huggingface.co/1T/wt-e5-small-ko-insurance-v1