지난 글에서 에이전트 안에서 Tool·Agent 를 찾는 검색용 e5 모델을 만들었다면, 이번에는 긴 약관 문서를 VectorDB 에 적재할 때 쓰는 인덱싱 전용 임베딩 모델을 만든 기록입니다. 결과 모델은 Hugging Face 에 wt-kure-insurance-v1 으로 공개해 두었습니다.
1. 학습 목적#
“VectorDB 적재용 long-text 인덱싱 특화 한국어 보험 임베딩 모델 개발”
- 이전 실험에서 OpenAI text-embedding-3-large 의 한국어 성능이 떨어지는 것을 확인했습니다.
- 앞서 만든 wt-e5-small-ko-insurance-v1 은 max context length 가 512 라서, 다양한 길이 특히 긴 context 를 임베딩해야 하는 인덱싱 작업에는 맞지 않습니다.
- 그리고 보험 도메인에서 사내 자산으로 쓸 수 있는 온프렘 임베딩 모델의 수요가 앞으로 더 생길 것으로 봤습니다.
정리하면, OpenAI 모델보다 한국어 임베딩 성능은 높으면서 long context 임베딩은 동등하게 지원하는 온프렘 모델이 필요했습니다.
2. 모델 선택 → KURE-v1#
아래 조건으로 후보를 골랐습니다.
- 기본 한국어 임베딩 성능이 SoTA 급일 것
- 인덱싱 목적에 맞게 long context 임베딩을 지원할 것 (OpenAI 와 같은 8,192 토큰 이상)
- 여러 도메인에서 고른 성능을 보이고, 오랜 기간 많은 사용 사례로 검증된 모델일 것
- GPU 가 없는 프로젝트에서도 쓸 수 있게 CPU 로도 구동 가능한 크기일 것
이 조건들에 가장 잘 맞는 nlpai-lab/KURE-v1 (bge-m3 backbone · 568M · 1,024 dim · max_seq 8,192)을 최종 선택했습니다.
(e5 를 쓰지 않은 이유는 단순합니다. e5 는 context 가 512 토큰이라 페이지 단위로 청킹해서 인덱싱하기엔 부족했습니다.)
3. 데이터 구성#
3.1 데이터 출처와 가공 파이프라인#
원본은 모 손해보험사가 운영하는 보험상품의 공식 문서 PDF 437건입니다. 상품당 약관, 사업방법서, 상품요약서가 평균 2.7종씩 있고, 총 42,626 페이지 분량입니다.
- 원본 PDF → 페이지 텍스트 : PyMuPDF 로 페이지 단위 추출
- L1 청크 풀 : (product_id × doc_type) 단위로 이어 붙인 뒤 tiktoken cl100k_base 기준 4가지 길이(256 / 1,024 / 4,096 / 7,500 토큰)로 분할, stratified sampling 으로 15,500 청크
- L2 합성 query : 청크마다 GPT-5.4 로 3가지 스타일(keyword / natural / specific) query 생성 → 46,500 query
- L3 hard negatives : base KURE 임베딩으로 cosine top-50 을 뽑고, NV-Retriever 3-tier 규칙(cross-product / same-product / extra)으로 query 당 8개 mining → 372,000 negative
- L4 split : product_id 단위로 train / eval / test = 80 / 15 / 5 분리 (row-level random 분리는 leakage 가 생겨서 쓰지 않았습니다)
일반 도메인 망각 여부를 보기 위한 외부 데이터로는 KLUE 벤치마크의 한국어 STS 519쌍(뉴스·위키 등, 보험과 무관)을 따로 두었습니다.
3.2 4-resolution 청크 통계#
| resolution | 학습 sample 수 | 평균 토큰 | 약관 | 사업방법서 | 상품요약서 |
|---|---|---|---|---|---|
| 256 | 5,000 | 236 | 3,989 | 602 | 409 |
| 1,024 | 5,000 | 787 | 3,975 | 611 | 414 |
| 4,096 | 3,000 | 3,168 | 2,276 | 420 | 304 |
| 7,500 | 2,500 | 6,165 | 1,892 | 355 | 253 |
| 합계 | 15,500 | 12,132 | 1,988 | 1,380 |
3.3 Query 합성 (청크당 3 variants)#
실제 사용자의 검색 패턴은 키워드 검색, 자연어 질문, 긴 시나리오 질문까지 다양합니다. 한 청크를 어떤 식으로 물어봐도 찾을 수 있도록, 청크 하나에 서로 다른 스타일의 query 를 3개씩 만들었습니다.
| variant | 토큰 범위 | 스타일 | 학습 효과 |
|---|---|---|---|
| keyword | 5 ~ 20 | 키워드 나열형 | 짧은 검색 query robustness |
| natural | 30 ~ 80 | 자연어 한 문장 질문 | 일반 사용자 query 분포 |
| specific | 50 ~ 150 | 다중 조건 / 시나리오 명시 | 복합 정보 검색 |
예를 들어 사업방법서의 256 토큰짜리 청크 하나(“보험료는 일시납을 원칙으로 하되, 필요한 경우 분할 영수할 수 있다 …")에 대해서는 아래 3개가 만들어졌습니다.
- keyword :
보험료 분할 영수 일시납 - natural :
이 상품의 보험료는 분할해서 납입할 수 있나요? - specific :
풍수해·지진재해보험법 제7조에 따른 보험료 지원이 있을 때, 국가/지자체 지원분과 주민 부담분을 따로 분할 영수받을 수 있는지 그리고 일시납 원칙과 어떻게 충돌하지 않는지 알려주세요
각 query 는 학습 시 (query, positive = 원본 청크, hard_negatives[K=4]) triplet 으로 묶여 들어갑니다.
(참고로 eval set 은 보통 best checkpoint 선정에 쓰이기 때문에 최종 평가에 섞으면 bias 가 생길 수 있어서 지양해야 합니다. 다만 이번 학습은 epoch 수가 적어 그 위험이 낮았고, 별도의 도메인 평가 데이터셋이 없어서 eval set 도 최종 평가에 포함했습니다.)
4. Loss Function → MNRL#
contrastive 학습의 표준인 MultipleNegativesRankingLoss 를 그대로 썼습니다. query 가 자기 positive 에는 가깝고, 다른 query 의 positive 들과 미리 mining 해둔 hard negative 들과는 멀어지도록 학습합니다.
L = - (1/B) Σ_i log( exp(s(q_i, p_i+) / τ)
                     / [ Σ_j exp(s(q_i, p_j) / τ) + Σ_k exp(s(q_i, p_k-) / τ) ] )

s(q, p) = cosine similarity (L2-normalized embeddings)
τ       = 0.05 (temperature)
B       = micro-batch size (per resolution)
분모     = in-batch negatives (B-1) + mined hard negatives (K=4)
5. 학습 파라미터#
| 항목 | 값 | 설명 |
|---|---|---|
| base model | nlpai-lab/KURE-v1 | bge-m3 backbone · 568M. LoRA adapter 만 학습, backbone 은 frozen |
| LoRA rank / alpha / dropout | 16 / 32 / 0.05 | adapter 약 7.1M params (전체의 1.24%) · 12MB |
| target modules | query, key, value, dense | 12개 transformer layer 전체 |
| learning rate | 1e-4 | base 가중치 변동을 적게 해서 일반화 성능을 지키는 쪽으로 |
| weight decay / warmup | 0.01 / 0.1 | |
| epochs | 3 | loss 0.73 → 0.21 |
| per-resolution batch | 256: 32, 1024: 16, 4096: 8, 7500: 4 | 긴 seq 일수록 VRAM 부담이 커서 batch 를 줄임 |
| effective batch | 64 | micro-batch 가 64 에 도달할 때까지 grad accumulate |
| hard negatives | 4 | 8개 mining 후 상위 4개만 사용 (+ in-batch negatives) |
| precision | bf16 + gradient checkpointing | |
| 학습 장비 · 시간 | H100 80GB × 1 · 약 15시간 21분 | peak VRAM 18.6GB |
5.1 Curriculum (epoch 별 resolution 비중)#
epoch 마다 resolution 별 sampling 비중을 바꿔서, 짧은 데이터로 먼저 워밍업한 뒤 뒤로 갈수록 긴 데이터에 집중하도록 했습니다.
| epoch | 256 | 1,024 | 4,096 | 7,500 |
|---|---|---|---|---|
| 1 | 50% | 30% | 15% | 5% |
| 2 | 20% | 25% | 25% | 30% |
| 3 | 5% | 15% | 30% | 50% |
6. 학습 중 Loss 추이#
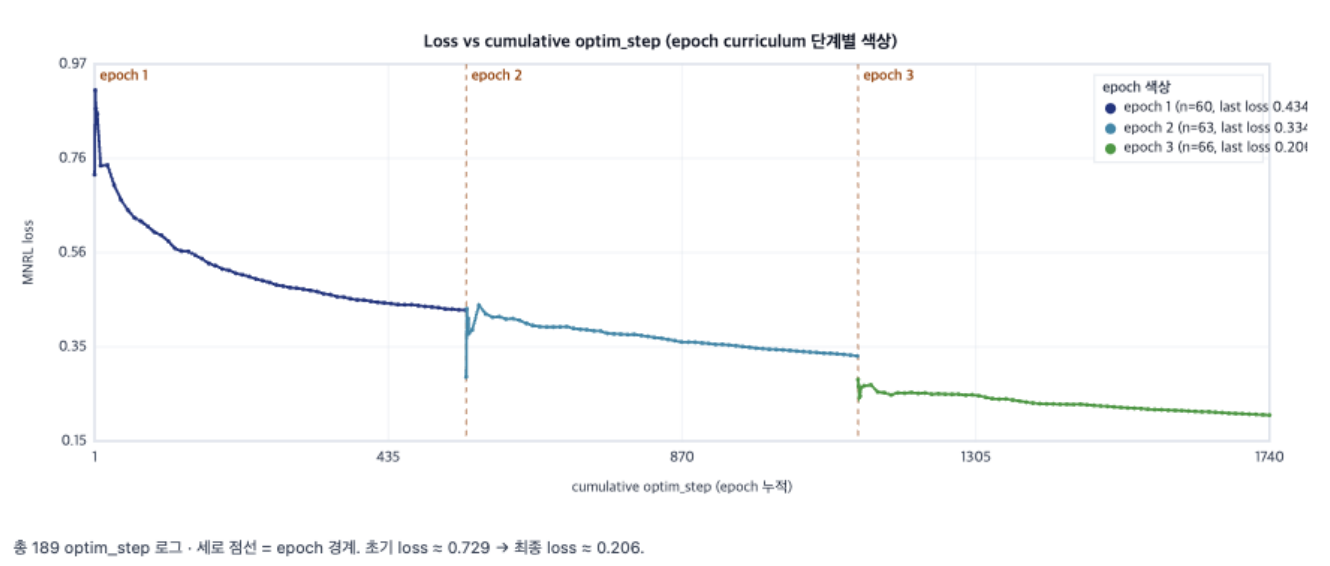
초기 loss 0.729 → 최종 0.206 으로 수렴했습니다. epoch 경계마다 튀는 구간은 curriculum 으로 resolution 비중이 바뀌는 지점입니다.
각 epoch 이 끝날 때 eval split 일부(resolution 당 corpus 300)로 빠르게 retrieval 을 재서, mean Recall@5 가 가장 높은 epoch 의 adapter 를 best 로 저장했습니다.
| epoch | mean Recall@5 | per-resolution Recall@5 |
|---|---|---|
| 1 | 98.00% | 256 = 100.0 · 1024 = 100.0 · 4096 = 97.7 · 7500 = 94.3 |
| 2 | 98.25% | 256 = 100.0 · 1024 = 100.0 · 4096 = 96.7 · 7500 = 96.3 |
| 3 | 98.17% | 256 = 99.7 · 1024 = 100.0 · 4096 = 97.0 · 7500 = 96.0 |
7. 평가#
7.1 평가 데이터와 비교 모델#
- In-domain (eval split, 5,397 query) : 학습에 참여한 상품의 미사용 query
- Out-of-domain (test split, 759 query) : 학습에 아예 참여하지 않은 상품 (product_id 단위 분리)
- KorSTS (519 pairs) : 일반 한국어 문장 유사도 Spearman 상관. catastrophic forgetting 확인용
| 모델 | dim | max_seq | 역할 |
|---|---|---|---|
| ft (FT KURE, 이번 모델) | 1,024 | 8,192 | 제안 |
| base (KURE-v1) | 1,024 | 8,192 | 한국어 SoTA, 학습 전 upper-bound |
| e5 (wt-e5-small-ko-insurance-v1) | 384 | 512 | 이전 글의 도메인 FT 모델 |
| openai (text-embedding-3-large) | 3,072 | 8,191 | 상용 SoTA |
(e5 는 max context 가 512 라서 1,024 이상의 청크는 잘려서 정보가 손실됩니다. 공정한 비교를 위해 e5 는 256 resolution 에서만 평가했고, 긴 문장 비교는 base KURE 와 OpenAI 로만 진행했습니다.)
7.2 In-domain 결과#
Recall@1
| resolution | ft | base | e5 | openai | ft vs base | ft vs openai |
|---|---|---|---|---|---|---|
| 256 | 96.32% | 93.23% | 93.75% | 89.73% | +3.09pp | +6.60pp |
| 1,024 | 94.77% | 88.46% | - | 76.51% | +6.31pp | +18.26pp |
| 4,096 | 82.06% | 65.16% | - | 37.02% | +16.90pp | +45.04pp |
| 7,500 | 77.74% | 55.59% | - | 18.22% | +22.15pp | +59.52pp |
Recall@3
| resolution | ft | base | e5 | openai | ft vs base | ft vs openai |
|---|---|---|---|---|---|---|
| 256 | 99.36% | 98.60% | 98.89% | 97.37% | +0.76pp | +1.98pp |
| 1,024 | 99.77% | 97.95% | - | 92.32% | +1.82pp | +7.45pp |
| 4,096 | 96.03% | 84.61% | - | 55.15% | +11.43pp | +40.89pp |
| 7,500 | 93.66% | 78.32% | - | 32.53% | +15.34pp | +61.13pp |
7.3 Out-of-domain 결과 (학습에 없던 상품)#
| resolution | R@1 ft | R@1 base | R@1 openai | R@3 ft | R@3 base | R@3 openai |
|---|---|---|---|---|---|---|
| 256 | 100.00% | 100.00% | 99.58% | 100.00% | 100.00% | 100.00% |
| 1,024 | 95.24% | 93.94% | 88.31% | 100.00% | 100.00% | 98.70% |
| 4,096 | 94.12% | 86.93% | 51.63% | 100.00% | 99.35% | 77.12% |
| 7,500 | 83.70% | 74.07% | 31.85% | 97.04% | 95.56% | 54.07% |
7.4 긴 문서일수록 격차가 벌어지는지#
짧은 문서(256)와 긴 문서(7,500)에서 각각 비교 모델과의 차이를 구해서 빼 봤습니다. 값이 양수면 긴 문서에서 격차가 더 크다는 뜻입니다.
| 비교 (eval split) | 256 Δ | 7,500 Δ | long − short |
|---|---|---|---|
| R@1 ft vs base | +3.09 | +22.15 | +19.05 |
| R@1 ft vs openai | +6.60 | +59.52 | +52.92 |
| R@3 ft vs base | +0.76 | +15.34 | +14.58 |
| R@3 ft vs openai | +1.98 | +61.13 | +59.15 |
test split 에서도 같은 방향(R@1 기준 base 대비 +9.63, openai 대비 +51.44)이었습니다. 짧은 문서에서는 다들 비슷하게 잘 찾지만, 문서가 길어질수록 OpenAI 모델은 급격히 무너지고 fine-tuning 한 모델은 버텨 줍니다.
7.5 KorSTS (일반화 forgetting 확인)#
| model | Spearman | ft 대비 |
|---|---|---|
| ft | 0.8766 | |
| base | 0.8774 | -0.07pp |
| e5 | 0.7996 | +7.70pp |
| openai | 0.8234 | +5.32pp |
보험 데이터로 학습한 뒤에도 일반 한국어 문장 유사도는 base 와 거의 같게(-0.07pp) 유지됐습니다.
7.6 Latency#
batch = 8, 3회 평균, query 1건당 ms 기준입니다. (CPU 는 Apple M-series 로컬, GPU 는 학습 프로파일 기반 추정치입니다.)
| 모델 · 환경 | seq 128 | seq 512 | seq 1,024 | seq 4,096 | seq 7,500 |
|---|---|---|---|---|---|
| ft · GPU (H100, bf16) | 3.0 | 6.5 | 13.0 | 52.0 | 124.0 |
| ft · CPU | 107.8 | 273.6 | 517.0 | 2,488.4 | 6,805.3 |
| base · CPU | 83.1 | 226.3 | 426.0 | 2,309.3 | 5,867.8 |
| e5 · CPU | 21.2 | 31.7 | - | - | - |
| openai · API (private endpoint, 네트워크 포함) | 115.0 | 127.0 | 123.1 | 174.3 | 156.3 |
adapter 가 붙는 만큼 base 보다 조금 느려지고, 7,500 토큰 문서를 CPU 로 임베딩하면 건당 6.8초 정도 걸립니다.
8. 정리#
- 도메인 성능 : eval split 기준 base 대비 R@1 평균 +12.11pp, R@3 평균 +7.34pp. 학습에 없던 상품(test split)에서도 R@1 평균 +4.53pp 올랐습니다.
- 일반화 : KorSTS -0.07pp 로 사실상 망각 없이 유지됐습니다.
- 비교 모델 : 256 resolution 에서 e5 와는 1승 3무, OpenAI 와는 전체 16개 비교에서 14승 2무였습니다. (R@1 + R@3 평균으로 OpenAI 대비 +25.61pp)
- 긴 문서 : 7,500 토큰 문서의 R@1 이 base 대비 +22.15pp, OpenAI 대비 +59.52pp 로, 문서가 길수록 격차가 커졌습니다.
e5(검색용)와 KURE(인덱싱용)는 지금도 같은 에이전트 안에서 역할을 나눠 쓰고 있습니다. 짧은 query 로 Tool·Agent 를 고르는 건 가볍고 빠른 e5 가, 긴 약관을 쪼개서 VectorDB 에 적재하는 건 KURE 가 맡는 구조입니다.
그리고 이후에 KURE-v2 가 공개되면서 이 모델을 교체할지 한 번 더 검토했는데, 그 내용은 다음 글에 정리했습니다.
- Hugging Face : https://huggingface.co/1T/wt-kure-insurance-v1