1. 검토 배경#
2026년 8월 17일, nlpai-lab 에서 KURE-v2 를 공개했습니다.
현재 모 손해보험사 에이전트에서는 인덱싱 전용 임베딩 모델로 KURE-v1 을 보험 도메인 데이터로 fine-tuning 한 모델(지난 글)을 쓰고 있습니다. 그런데 새로 나온 KURE-v2 가 MTEB(kor, v2) 리더보드 1위를 기록해서, 차기 프로젝트에 적용할 만한지 도입 타당성을 검토해봤습니다.
2. KURE-v2 구조 이해#
2.1 Backbone#
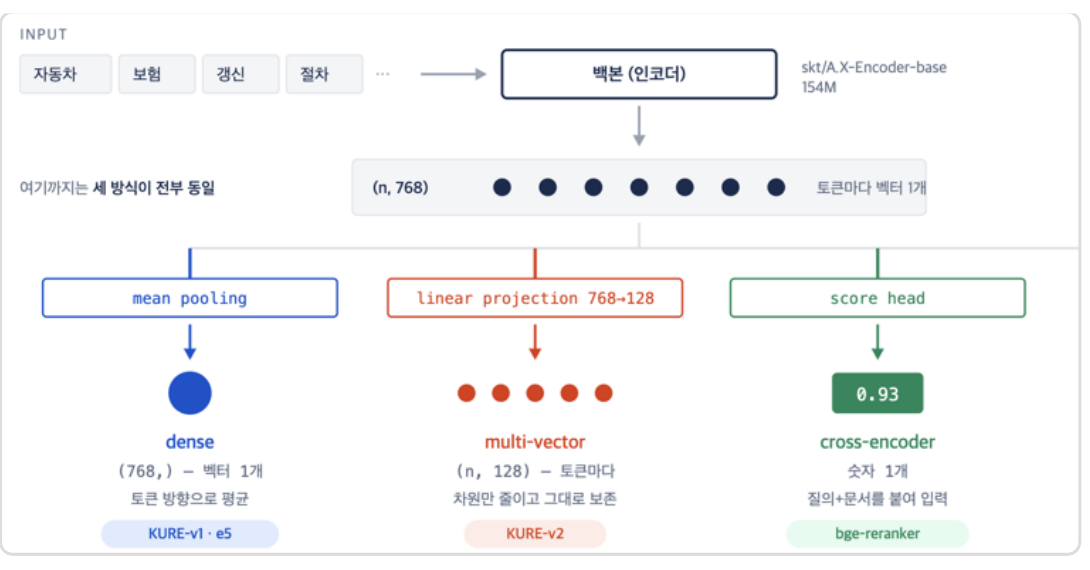
- 백본은
skt/A.X-Encoder-base이고, ModernBERT 계열 154M 파라미터 모델입니다. BAAI/bge-m3기반(568M)인 KURE-v1 의 약 1/4 크기입니다.- 백본 인코더 output 에 dense pooling(토큰 × 768dim 을 mean pooling 으로 1 × 768dim 으로)을 붙이면 단일벡터 모델이 되고, 토큰별 projection(토큰 × 768dim 에 128dim layer 를 투사해서 토큰 × 128dim 으로)을 붙이면 멀티벡터 모델이 됩니다. KURE-v2 는 후자를 선택했습니다.
2.2 핵심 차이#
| 구분 | KURE-v1 (dense) | KURE-v2 (multi-vector) |
|---|---|---|
| Shape | 1,024차원 벡터 1개 | 토큰마다 128차원 벡터 |
| 생성 방식 | 토큰 벡터를 mean pooling 으로 압축 | 토큰 벡터(encoder output)를 linear projection 으로 768 → 128 축소 후 그대로 보존 |
| 유사도 계산 | 벡터 간 내적 1회 | MaxSim (질의 토큰 × 문서 토큰 전수 대조) |
| 질의 길이 | 가변 (최대 8,192) | 64 토큰 고정 (패딩 / 절삭) |
| 인덱스 | HNSW | PLAID / BinaryIVF (전용) |
2.3 MaxSim (late interaction)#
질의 토큰 각각에 대해 문서 토큰 전체와 유사도를 계산하고, 행별 최댓값만 뽑아서 합산합니다. 질의와 문서를 미리 섞지 않고 검색 시점에 늦게(late) 맞대 본다는 의미에서 late interaction 이라고 부릅니다.
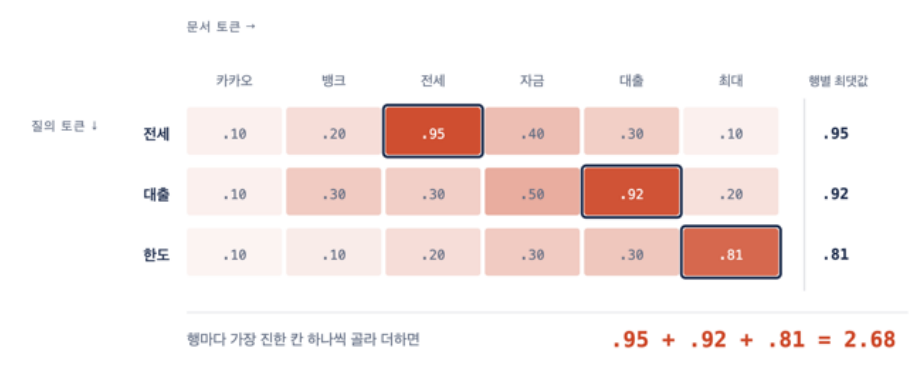
위 그림에서 굵은 테두리 3개가 서로 다른 열에 있다는 점이 핵심입니다. 질의 단어들이 문서의 각기 다른 위치에서 매칭되는 구조라, 단일벡터의 “평균 압축” 문제가 사라지고 질의 단어들이 문서 여기저기에 흩어져 있을 때 강합니다.
3. 성능#
| 지표 | KURE-v1 | KURE-v2 |
|---|---|---|
| MTEB(kor, v2) nDCG@10 | 0.7616 (dense 중 8위) | 0.8160 (전체 1위) |
| MLDR-ko (장문 검색) | 0.4521 | 0.6914 |
| Param | 568M | 154M |
| License | MIT | Apache-2.0 |
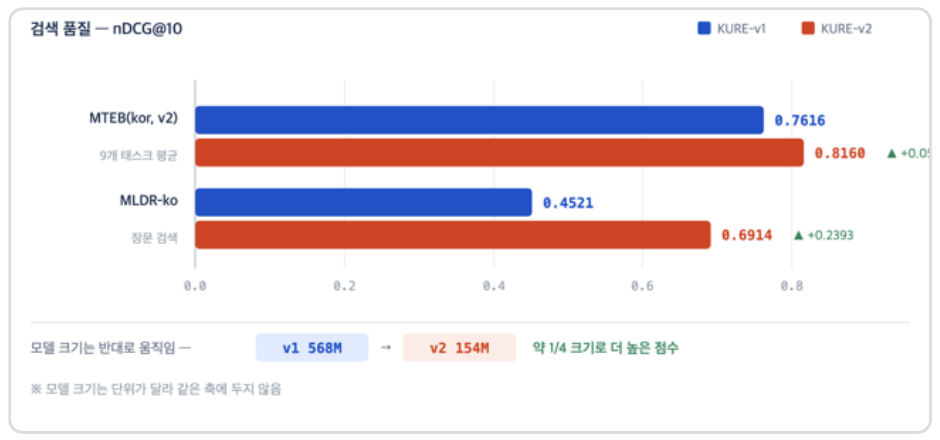
파라미터는 1/4 인데 MTEB(kor, v2) 는 +0.0544, 장문 검색(MLDR-ko)은 +0.2393 을 기록했습니다. 특히 긴 문서에서 격차가 크게 벌어지는데, dense 벡터는 평균으로 압축하는 과정에서 장문의 정보를 잃기 때문입니다.
4. Index 크기#
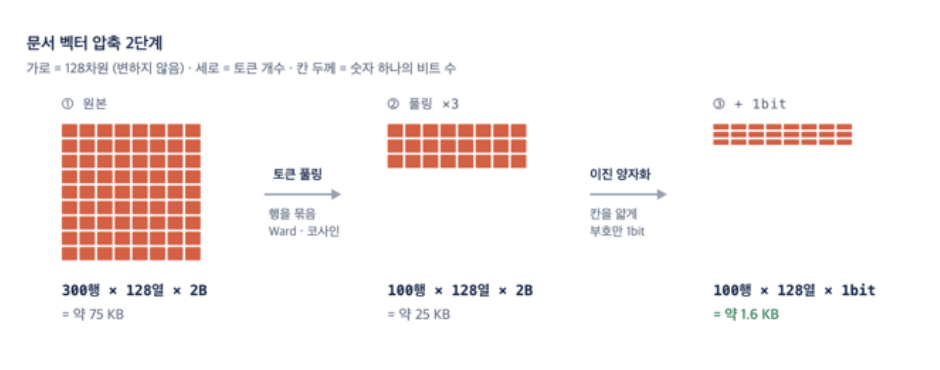
일반적으로 멀티벡터는 토큰마다 벡터를 저장하니 원칙적으로는 용량이 큽니다. 다만 KURE-v2 는 두 가지 압축을 적용해서 오히려 dense 벡터보다 작아지도록 만들었습니다.
4.1 토큰 풀링 (hierarchical token pooling)#
- 텍스트를 잘라서 토큰을 줄이는 게 아니라, 백본이 벡터를 다 만든 뒤에 이미 생성된 벡터 중 유사한 것끼리 묶는 방식입니다.
- 유사도 판정은 코사인, 병합은 Ward linkage 계층 클러스터링, 클러스터 대표는 mean pooling 으로 만듭니다. (원본 벡터는 버립니다)
- 묶는 개수는
pool_factor로 조절합니다. 거리 임계값이 아니라 상한 클러스터 수를 고정해두는 방식입니다. (최대토큰수 / pool_factor + 1개) - 문서에만 적용하고 질의에는 적용하지 않습니다.
- 학습이 필요 없고, 인덱싱 시점에 적용하는 후처리입니다. (Ref. arXiv 2409.14683, Clavié · Chaffin · Adams, 2024-09)
4.2 비대칭 이진 양자화 (asymmetric binary quantization)#
- 문서 토큰 벡터의 각 차원을 1비트만 남깁니다. (bf16 16비트 → 1비트)
- 질의는 bf16 을 그대로 둡니다. 이게 “비대칭” 의 의미인데, 문서는 수억 개가 저장되지만 질의는 요청당 1개라 양자화해도 이득이 거의 없어서, 한쪽만 양자화해서 오차를 줄이는 방식입니다.
- 인덱스는 9.4배 줄어들고, nDCG@10 손실은 1.05 (×100 스케일) 입니다.
- 차원 수 128 은 그대로이고, 줄어드는 건 토큰 개수와 숫자 하나당 비트 수뿐입니다.
5. 도입 검토 결과#
긴 context 에 강점이 있는 모델이라, 인덱싱 용도로 fine-tuning 해서 쓰고 있는 KURE-v1 의 대체 후보로 놓고 접근했습니다. 적용 방식은 두 가지를 고민했습니다. KURE-v1 이 맡고 있는 인덱싱 모델 자리를 그대로 바꾸는 방법(경로 A)과, 기존 RAG 검색 성능을 높이는 Rerank 모델로만 쓰는 방법(경로 B)입니다.
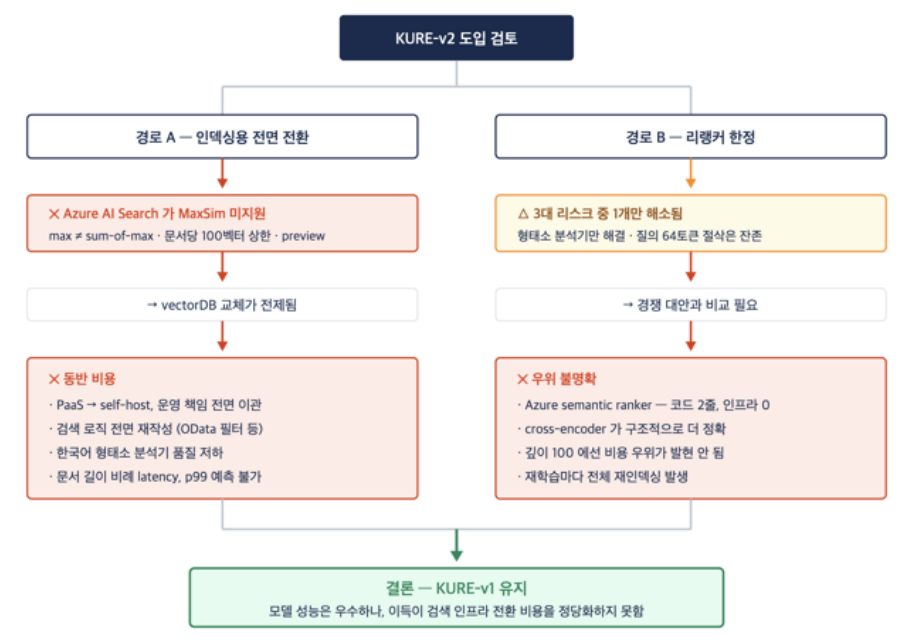
다만, 아래 리스크 때문에 KURE-v2 도입 검토는 철회하고, 아직은 KURE-v1 을 유지하기로 했습니다.
- Azure AI Search 를 쓸 수 없습니다. Multi-Vector 방식의 모델을 쓰려면 MaxSim 기반 검색이 필요한데, Azure AI Search 는 이를 지원하지 않습니다. 결국 Vespa, Weaviate, Milvus, Qdrant 처럼 MaxSim 을 지원하는 DB 를 VM 안에 self-hosted 로 구축해야 하고, 그러면 SLA, 백업, 복구, 버전 업그레이드, HA 구성 같은 인프라 부담을 새로 떠안게 됩니다.
- 검색 로직을 새로 개발해야 합니다. VectorDB 와 인덱싱 형태가 달라지니 기존 검색 로직을 그대로 쓸 수 없습니다.
- latency 가 문서 길이에 따라 들쭉날쭉합니다. 기존 dense vector 는 문서가 길든 짧든 1,024dim 벡터 간 유사도 계산 한 번이면 끝나지만, multi-vector 는 토큰 개수 × 128차원 벡터 간 연산이라 검색된 문서가 클수록 MaxSim 연산량과 latency 가 같이 커집니다. 검색 속도의 일관성이 떨어지고, p99 쪽으로 갈수록 부담이 매우 커집니다.
- 한국어 형태소 분석기를 못 씁니다. 고품질의 Azure AI Search 한국어 형태소 분석기를 활용하지 못하게 되어, lexical search 성능이 떨어질 수 있다는 우려도 있었습니다.
6. 결론#
Multi-Vector 기반 임베딩 모델은 토큰 단위 vector 구조로 장문의 맥락 소실 문제를 크게 개선했습니다. 다만 장문 임베딩 성능이 특별히 요구되는 상황이 아니라면, 위에서 정리한 인프라 부담과 연산 부하, latency 문제 때문에 프로덕션에서 기존 dense 임베딩 모델을 교체할 동기는 아직 부족하다고 판단했습니다.